
AI služby dnes neposílají na weby jen jeden typ robota. Stejný poskytovatel může provozovat crawler pro získávání dat, robota pro AI vyhledávání i klienta, který stránku otevře na přímý požadavek uživatele. A právě tady se internet začíná měnit.
Dříve bylo relativně jednoduché rozlišit člověka, klasický vyhledávač a škodlivého robota. Dnes mezi nimi vzniká nová a rychle rostoucí skupina provozu – AI roboti.
A stejně rychle, jako se mění oni, se musí měnit i WEDOS Global Protection.
V poslední době jsme proto udělali další větší krok a začali známé AI roboty nejen identifikovat, ale také rozdělovat podle toho, co skutečně dělají.
GPTBot není ChatGPT-User
Dobrým příkladem je OpenAI.
Pod jednou společností může přijít několik velmi odlišných typů provozu.
GPTBot může systematicky procházet velké množství obsahu.
OAI-SearchBot získává data pro AI vyhledávání.
ChatGPT-User může přijít ve chvíli, kdy konkrétní uživatel požádá ChatGPT o otevření určité stránky.
Z pohledu serveru jde pokaždé o automatizované HTTP požadavky.
Jejich význam je ale úplně jiný.
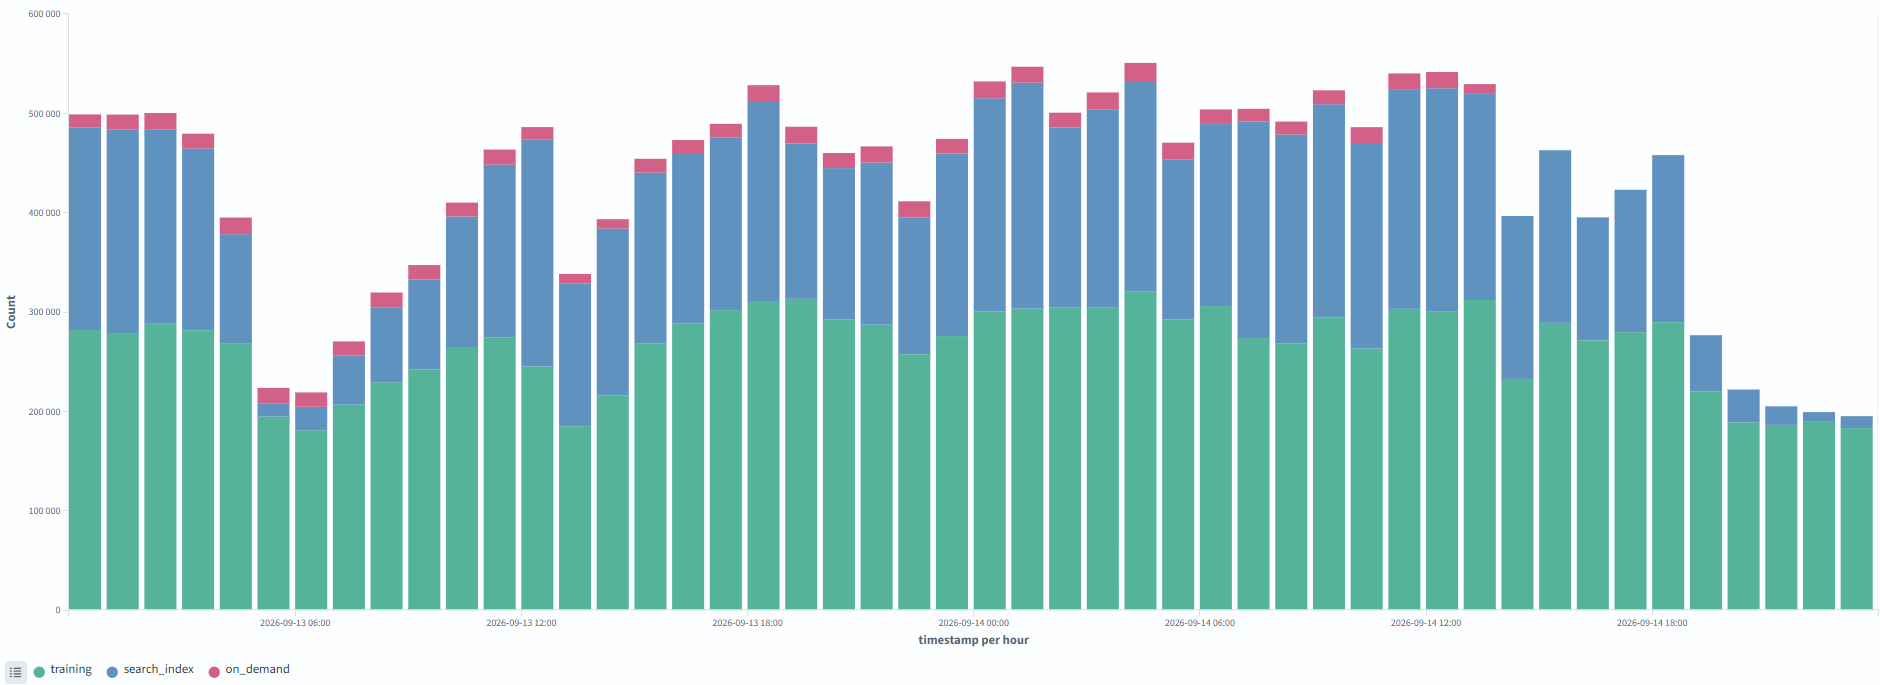
Proto dnes AI provoz rozdělujeme například do těchto skupin:
| Typ | Co dělá |
|---|---|
training | systematicky získává obsah pro práci s AI modely |
search_index | prochází web pro AI vyhledávání a tvorbu odpovědí |
on_demand | požadavek vzniká přímo akcí uživatele AI asistenta |
Tohle rozdělení není jen pro statistiky. Umožňuje nám s jednotlivými druhy provozu zacházet rozdílně.
Data jsou cenná. A každý je chce co nejrychleji
Provozovatelé AI systémů potřebují data. Hodně dat. A ideálně co nejrychleji.
Crawler se proto nemusí chovat jako klasický návštěvník, který otevře stránku, chvíli ji čte a potom klikne dál. Může během krátké doby projít stovky nebo tisíce URL.
Samo o sobě to samozřejmě neznamená útok. Z pohledu serveru ale může být výsledek velmi podobný. I legitimní robot dokáže vytvořit takovou zátěž, že začne ovlivňovat běžné návštěvníky webu. A s podobnými případy jsme se už v minulosti setkali.
Proto nechceme známé AI roboty jednoduše označit jako důvěryhodné a pustit je bez omezení.
Potřebujeme vědět, kdo jsou, co dělají a v případě potřeby jejich provoz omezit dřív, než začne zákazníkovi vadit.
Jeden požadavek uživatele nemusí znamenat jeden request
Ještě zajímavější jsou požadavky vyvolané přímo uživateli AI služeb. Uživatel například položí otázku a očekává odpověď během několika sekund. AI služba kvůli tomu může potřebovat získat informace z několika stránek nebo z jedné stránky stáhnout více zdrojů současně.
Jeden požadavek uživatele tak nemusí znamenat jeden HTTP request. Může jich vzniknout několik, někdy i desítky téměř současně.
Záleží také na tom, jak má konkrétní AI služba navrženou cache. Ne každý AI systém si jednou získaný obsah uloží a použije ho při dalším dotazu. Část provozu tak může vznikat opakovaně.
A uživatel na druhé straně samozřejmě čekat nechce. Výsledkem je tlak na co nejrychlejší paralelní získávání dat. Z pohledu AI služby logické. Z pohledu webserveru už to ale může vypadat jako velmi agresivní automatizovaný provoz.
Známý AI robot neznamená neomezený přístup
Proto pro nás informace:
tato IP patří známému AI providerovi
neznamená:
obejdi všechny ochrany
Znamená pouze, že víme více o původu provozu.
Celý princip se dá zjednodušit na tři kroky:
ověření → klasifikace → akce
Nejdřív chceme vědět, kdo požadavek posílá. Potom, k čemu daný robot slouží. A teprve nakonec se rozhoduje, jak s ním zacházet. Výsledkem může být například běžné povolení provozu, rate limit, ověření pomocí Proof of Work nebo úplné zablokování.
Důležité je, že identita robota a jeho oprávnění nejsou totéž.
Proč je rozdělení AI robotů důležité
Systematický crawler pro získávání velkého množství obsahu má jiný charakter než požadavek vytvořený konkrétním uživatelem AI asistenta. Pokud crawler začne stahovat příliš agresivně, můžeme jeho provoz omezit.
U on_demand provozu naopak víme, že za requestem může čekat skutečný člověk, který právě používá AI službu a očekává odpověď. Právě proto nechceme všechny AI roboty naházet do jednoho seznamu a aplikovat na ně stejné pravidlo.
Potřebujeme mít možnost říct:
známe tě
víme, co děláš
ale pokud to přeženeš, zpomalíme tě
To je zásadní rozdíl proti klasickému whitelistu.
AI provoz bude dál růst
Dnes řešíme crawlery, AI vyhledávání a požadavky vyvolané uživatelem.
Dalším krokem budou stále častěji AI agenti, kteří budou za uživatele procházet weby, porovnávat nabídky, získávat informace nebo přímo komunikovat s webovými službami.
Rozdělení na:
člověk / robot
už proto dlouhodobě nebude stačit. A brzy nebude stačit ani:
dobrý robot / špatný robot
Potřebujeme vědět, kdo přichází, proč přichází, jak se chová a jak velkou zátěž vytváří. Právě tímto směrem teď posouváme WEDOS Global Protection. AI roboti nejsou automaticky problém. Ale nejsou ani provoz, kterému bychom měli bez dalšího otevřít dveře dokořán.
A čím větší část internetu budou AI systémy procházet, tím důležitější bude ten rozdíl umět poznat.